Новый алгоритм ускоряет работу ИИ на видеокартах Intel Arc
Специальный программный код для архитектур Intel Arc и Xe значительно ускорил процесс обработки запросов в llama.cpp. Новые функции позволяют видеокартам быстрее «читать» текст перед генерацией ответа.
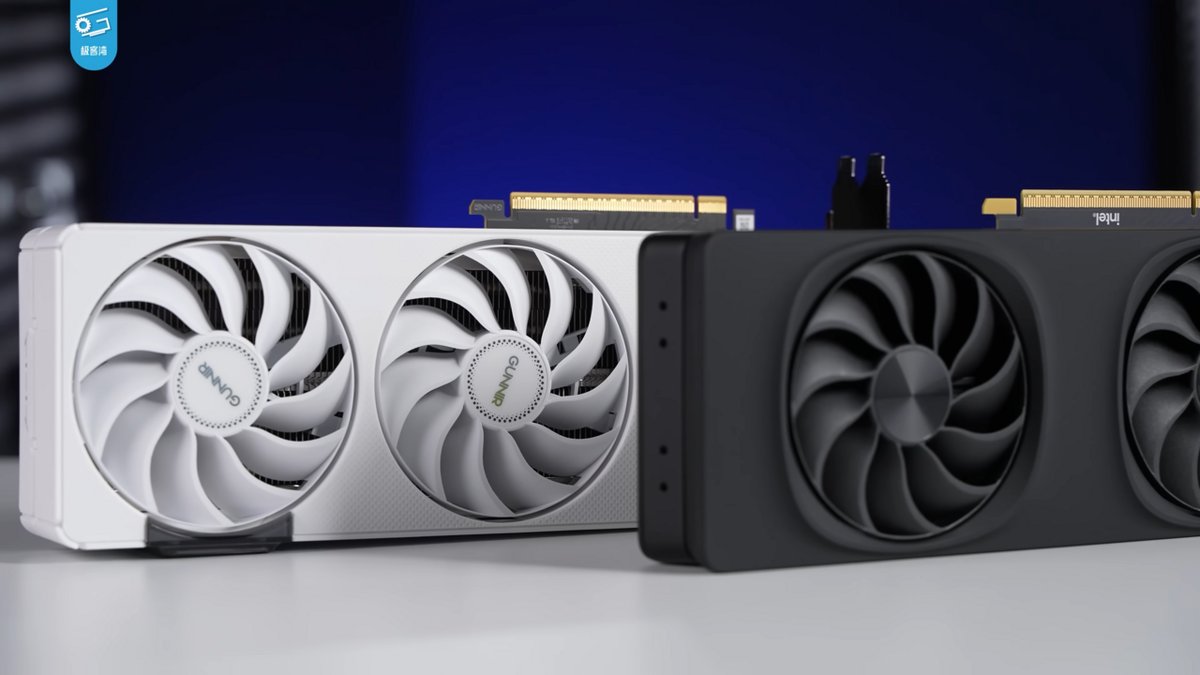
В мастер-ветку llama.cpp добавили выделенное ядро для ускорения процесса prefill (подготовки контекста) через Vulkan. Это решение использует кастомные шейдеры, чтобы задействовать матричные ядра и архитектуру SLM в чипах Intel. На некоторых платформах, таких как ARL-H и Xe2/Xe3, скорость обработки запросов выросла в разы. Например, на модели qwen3 8B скорость поднялась со 126 до 415 токенов в секунду.
Для обеспечения стабильности разработчики пока ограничили использование нового ядра конкретными архитектурами. На видеокартах вроде A770 функция отключена из-за нестабильных результатов тестов. Кроме того, оптимизация затронула модели с архитектурой MQA и MLA, что расширило возможности бэкенда.
Что поменялось
Скорость prefill (первичной обработки текста) на поддерживаемых архитектурах Intel значительно выросла за счёт оптимизированных шейдеров.
Текст подготовила языковая модель по материалам источников.