Ускорение нейросетей без замены видеокарт
Смена формата данных и оптимизация работы с памятью позволяют поднять скорость генерации текста почти вдвое. Новые методы решают проблему, когда размер модели превышает объём видеопамяти.
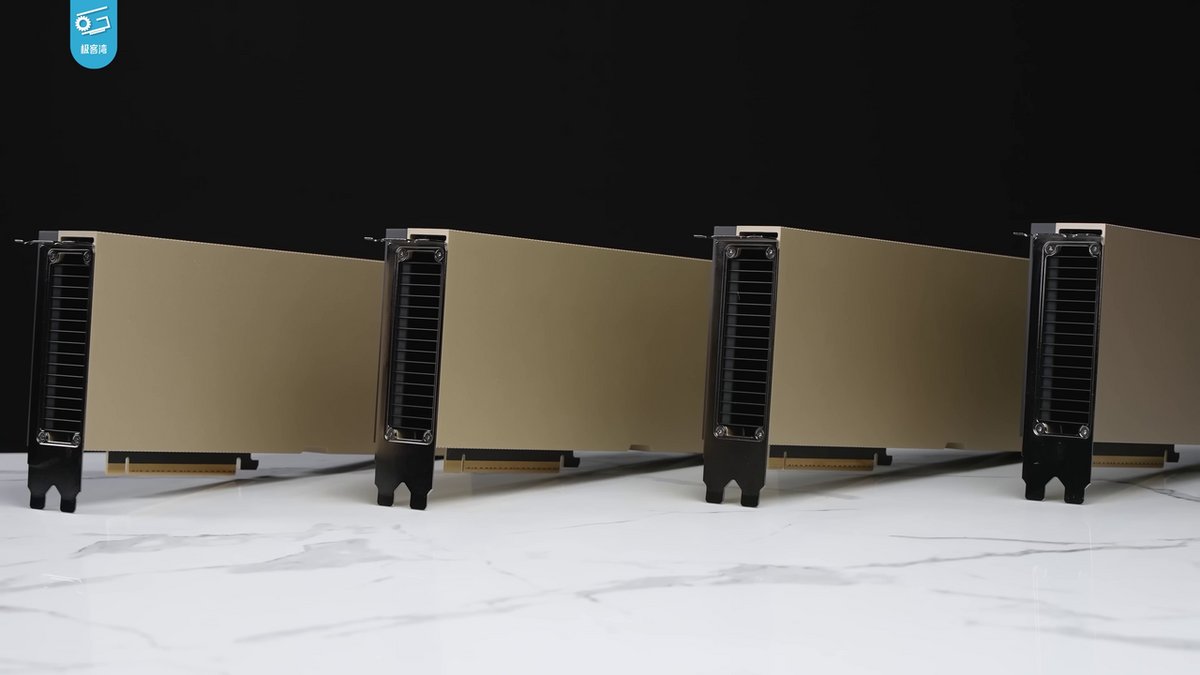
Для ускорения работы Qwen3-32B на кластере NVIDIA A100 участники воркшопа использовали переход с формата BF16 на FP8. Это позволило увеличить скорость генерации для одного пользователя на 49,4%, при этом общая пропускная способность выросла на 12,5%. В BF16 для весов используется 16 бит, а в FP8, всего 8, что снижает объём передаваемых данных.
Когда модель значительно больше доступной видеопамяти, на помощь приходят патчи для распределения нагрузки между GPU и процессором. Инструмент tandem.cpp позволяет держать активные эксперты в видеокарте, перенося остальное на CPU.
На тесте с моделью DeepSeek-V4.1 на ПК с 64 ГБ оперативной памяти скорость выросла с 7,4 до 14,2 токенов в секунду при использовании видеокарты RTX 5070 Ti 16 ГБ. На более мощной RTX 5090 прирост составил от 10,4 до 33,1 токена в секунду.
Оптимизация работы с инструкциями процессора также даёт результат. При использовании ядер AVX-VNNI на ноутбуке с RTX 4070 скорость генерации для модели Qwen3.8-Flash-Next при использовании квантования Q2_0 выросла с 3,1-4,1 до 15,5-21,4 токенов в секунду. Это происходит за счёт ускорения вычислений на стороне процессора при гибридном режиме работы.
Для ускорения передачи данных между компонентами разработан инструмент cmt tune. При тестировании модели Qwen3.6-35B на видеокарте RTX 3090 настройка cudaMemcpy позволила поднять скорость префилла с 345 до 466 токенов в секунду.
Что поменялось
Скорость генерации может вырасти на 50% и более за счёт смены формата весов или оптимизации передачи данных, но это требует проверки точности ответов.
· обновлено, версия 5
Источники · 4
- [Перевод] Как ускорить локальную LLM на 50% без покупки новой видеокарты
- Update: tandem.cpp — DeepSeek-V4.1 on a 64 GB PC with a 16 GB card, and AMD (ROCm) support
- CPU-only boost for Q2_0 on AVX-VNNI · Pull Request #26348 · ggml-org/llama.cpp
- MoE offload on a 3090: prefill 345 -> 466 t/s by tuning cudaMemcpy (Qwen3.6 35B-A3B)
Текст подготовила языковая модель по материалам источников.