Пересборка генома. Как устаревший референс мешает анализу
Попытка проанализировать геном 67-летнего биофизика Вадима Зорина с помощью современного софта обернулась техническим тупиком. Выяснилось, что данные от лаборатории нельзя использовать в новых проектах из-за устаревшего стандарта сборки.
Проблема возникла на этапе загрузки данных в проект Just-DNA-Lite. Лаборатория выдала список генетических вариантов, собранный по стандарту hg19 (версия 2009 года). Современные инструменты и базы данных ориентируются на более актуальный референс GRCh38, а старая сборка не позволяет корректно сопоставлять позиции генов. Из-за этого программа при попытке анализа просто зависала.
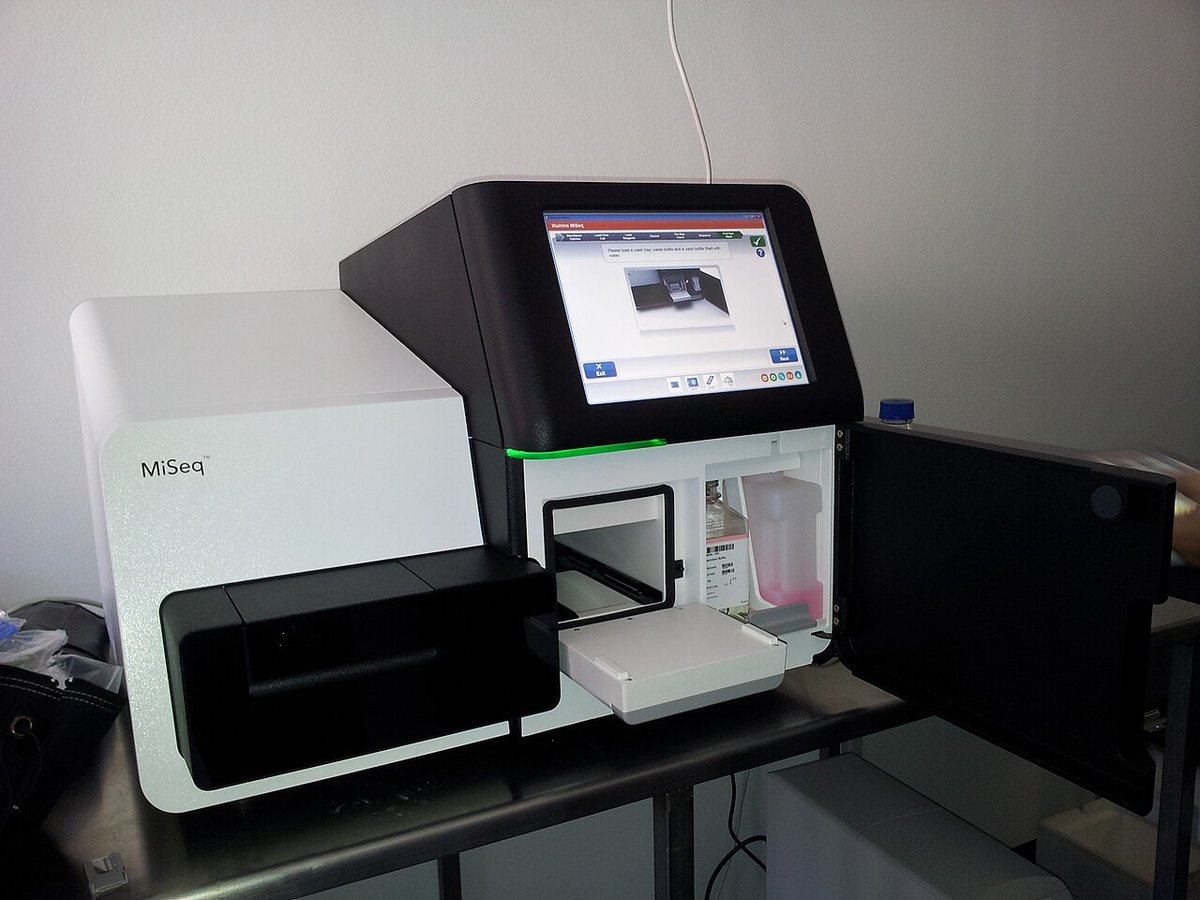
Чтобы исправить ситуацию, исследователям пришлось вернуться к «сырым» данным, ридам. Это короткие фрагменты ДНК длиной около 150 букв, которые секвенатор считывает из разрешенного генома. Собрать из сотен миллионов таких фрагментов цельный пазл, задача, требующая пересборки всего генома с нуля на новом стандарте.
В ходе работ команда также протестировала разные способы вызова вариантов. Оказалось, что выбор лучшего алгоритма зависит от оборудования: для секвенаторов Illumina лучше всего подошёл pangenome-aware DeepVariant, а для MGI, обычный DeepVariant. Использование нейросетевых методов позволяет точнее находить отличия в ДНК, чем классические статистические программы.
Для читателя это означает, что наличие готового списка генетических данных от лаборатории не гарантирует возможность их глубокого анализа. Если сборка сделана по старому стандарту, её придётся пересобирать вручную с помощью специализированного софта, чтобы данные соответствовали современным базам.
Текст подготовила языковая модель по материалам источников.